Para descargar el Sistema Operativo tOSh, podés hacerlo desde la sección Resources de este mismo sitio.
Partes
Esta serie de artículos tiene las siguientes partes:
- Parte I - Bootloader
- Parte II - Stage 1
- Parte III - Saltando a C <— Estás acá
- Parte IV - Interrupciones
- Parte V - Sistema de Archivos y Driver de Disquetera
- Parte VI - Booteando en diferentes tipos de máquinas
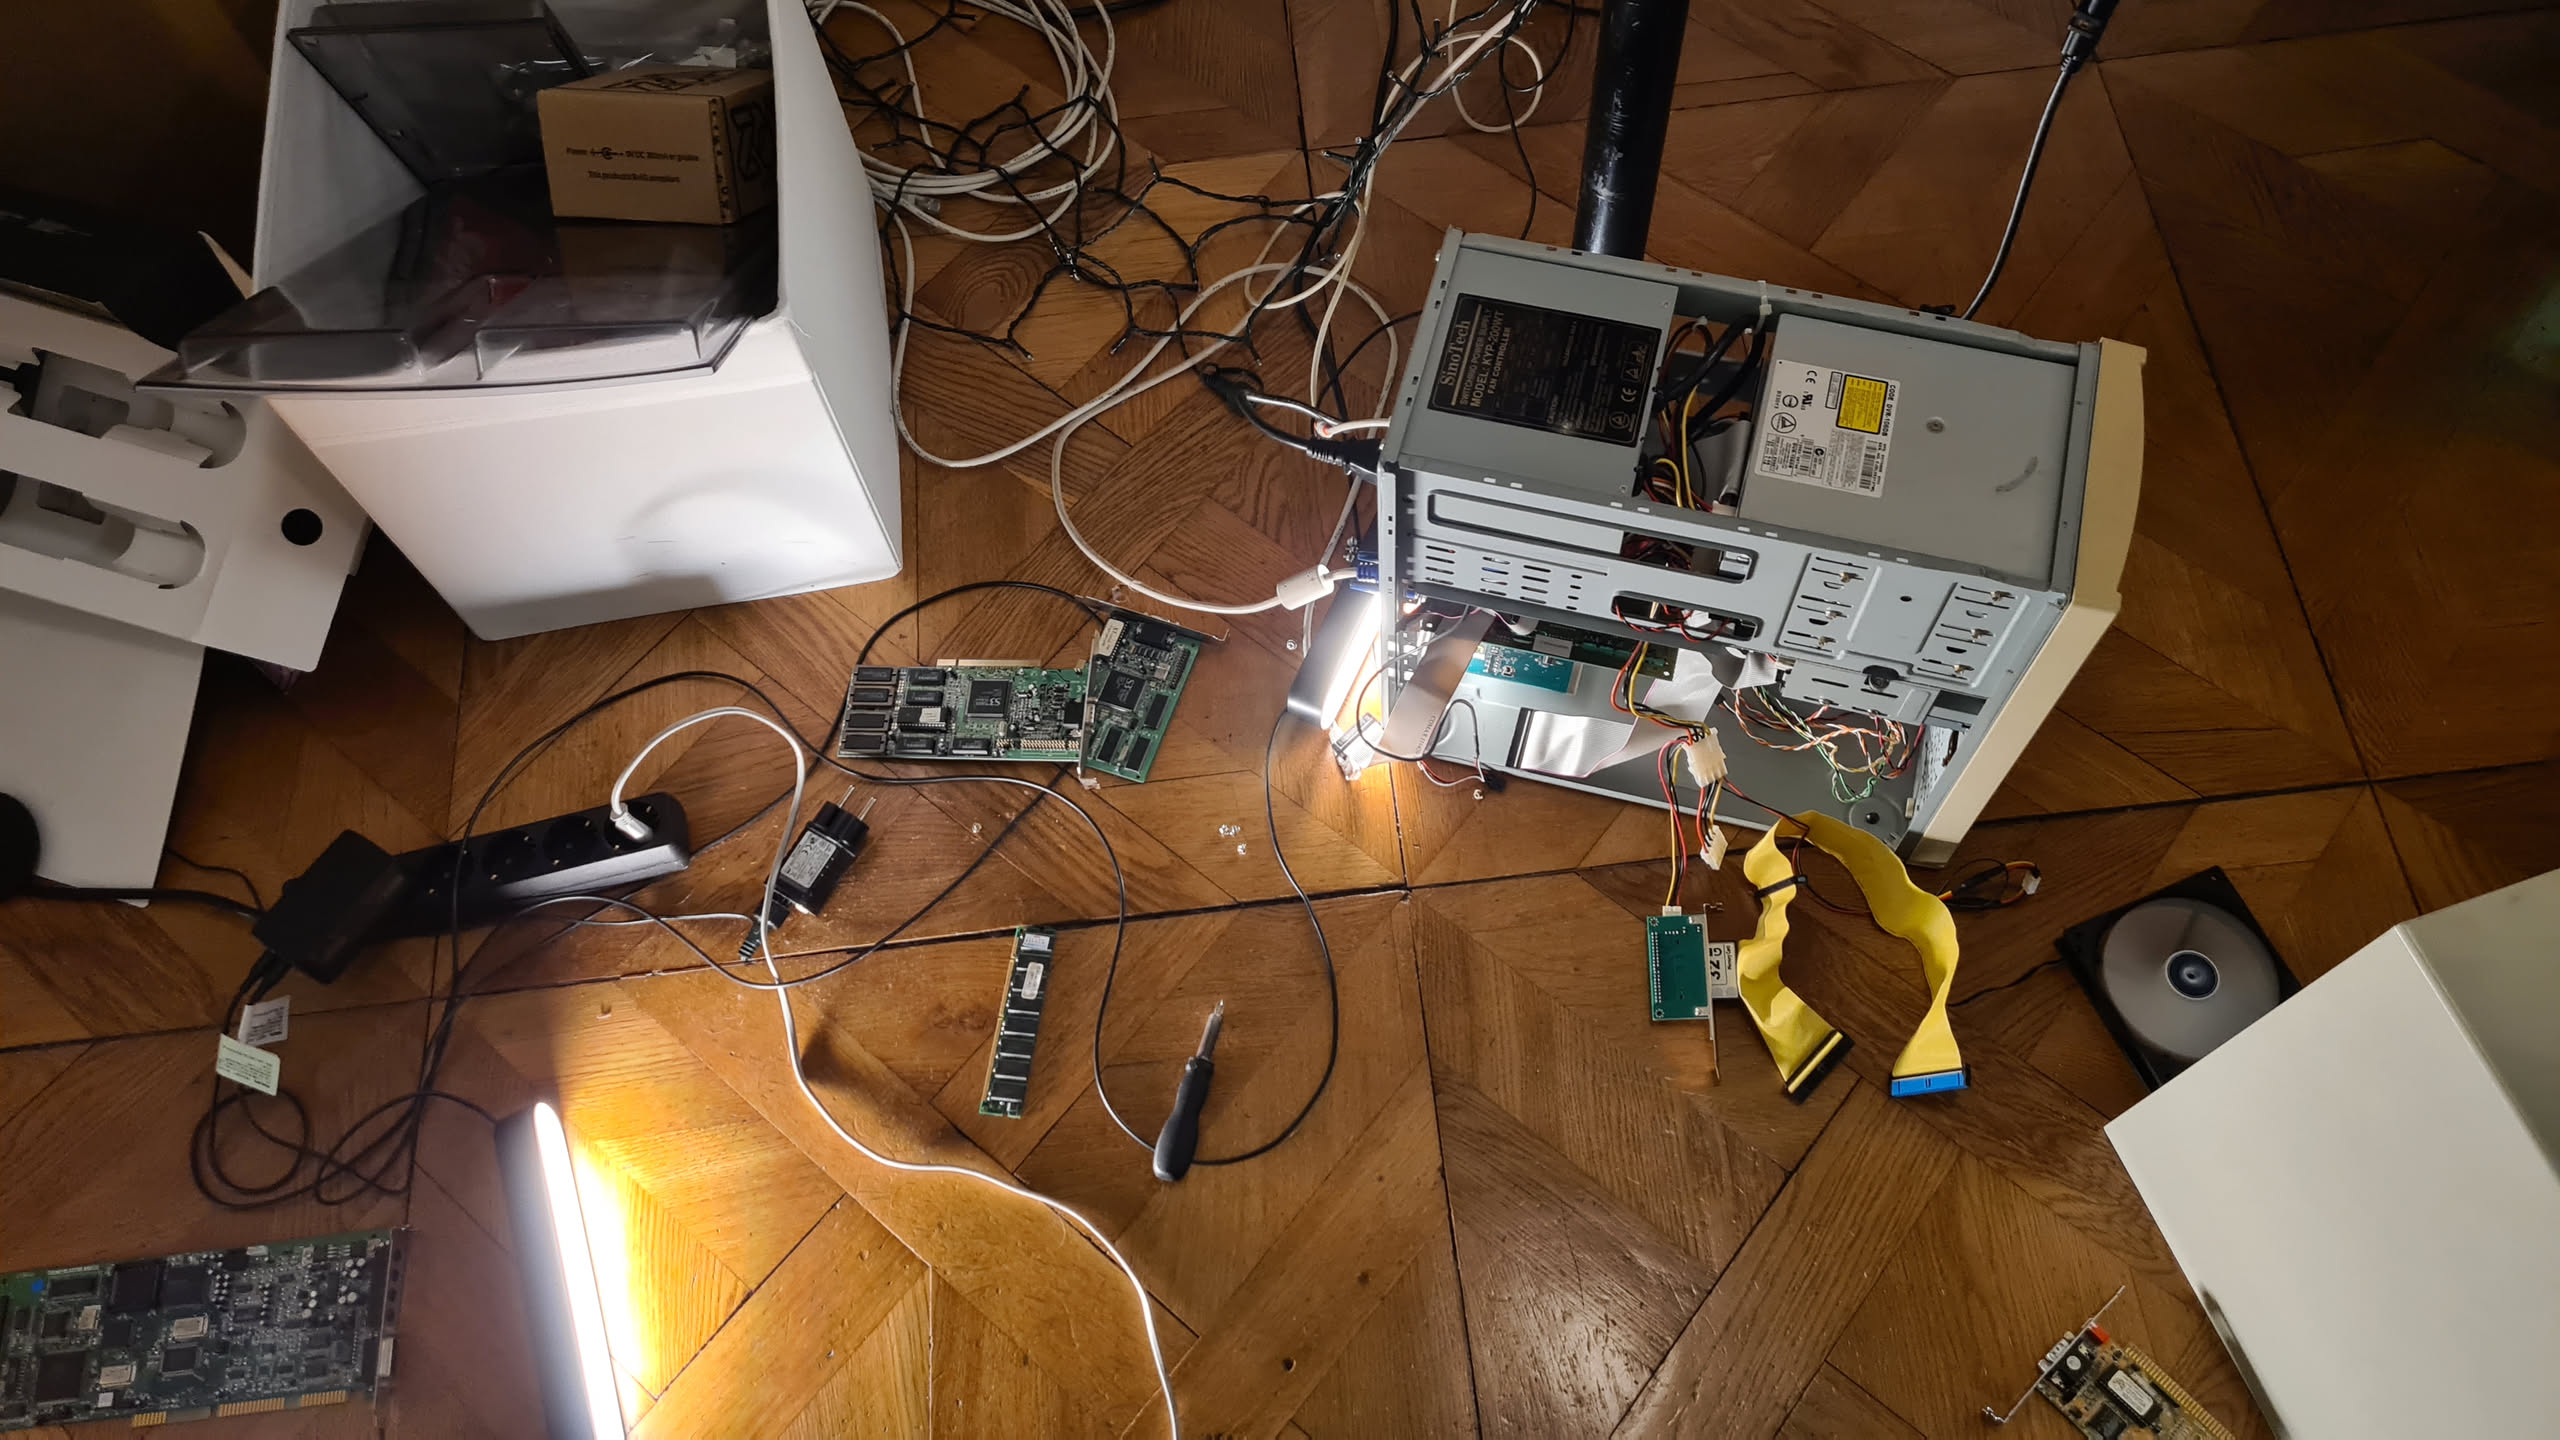 Armando Máquina de 1997
Saltando a C
A veces, mientras escribo esta serie, me hago la pregunta que si es necesario estar explicando todos los conceptos de cada palabra especializada que uso como Kernel y nunca sé bien cuán profundo tengo que ir en mis artículos. Después lleno los términos de links y se me pasa. Mientras escribo exactamente esta oración me estoy preguntando: ¿Tengo que explicar que es un Kernel? Me parece que no. Si estás leyendo esto, asumo que sabés un montón. Y si no, igual te lleno de links por cada término técnico que uso para que puedas seguir investigando por tu cuenta.
Bien. Tenemos que armar un Kernel, porque ya estamos saltando a él, pero no hablamos de nada sobre como empezar a escribir bytes para un sistema operativo desde C.
Lo primero y quizá lo más importante de todo lo que tenés que saber sobre desarrollo de Kernel es que no podés programar así nomás, pim pam pum,
agarro un gcc o un clang ¡paf! le chanto un main.c y a compilar y meter el binario donde se te cante.
¡Noooooo! Lo que necesitás hacer primero es prepararte un crosscompiler, es decir, un compilador que permita escribir binarios para otras
arquitecturas sin depender de las bibliotecas que vienen con el sistema operativo o sus ABI objetivo porque no hay ABI.
Es decir, no hay librerias, no hay interfaces, no hay syscalls, no hay nada porque no tenés kernel, ¡porque estás haciendo uno!
Parece una obviedad mencionar esto, pero si nos detenemos un segundo a pensar, uno está acostumbrado a tener cientos
de capas de abstracción que evitan estar interactuando con el CPU y resolver cientos de problemas que se computan casi mágicamente
con una o dos llamadas a función. Hacer un printf estándar de C es sorprendentemente complicado y es un rabbit hole en el cual
hoy no, pero algún día entraré.
Dicho todo esto recomiendo fuertemente leer el artículo GCC Cross-compiler de osdev.
De KMain, Linkers y Bash
Este va a ser nuestro Kernel por ahora. Lo único que va a hacer es escribir el caracter "X" en la posición de memoria VGA xb8000 que es el área de memoria donde la placa de video está mirando su contenido para replicarlo en el monitor correspondiente y eventualmente terminamos crasheando el CPU porque seguimos escribiendo linearmente hasta 2^32 - 1 o mejor aún, hasta el límite de la memoria que tengamos instalada en el hardware.
__attribute__((section(".text.kmain_entrypoint")))
int kmain(void) {

    char * vga = (char *) 0xb8000;
    *vga = 'X';

    while(1){
        *(vga++) ='X';
    };

    char * str = "end of kernel code.";
    return 1;
}
Compilar este código requiere por lo menos el siguiente Makefile.
Primero definimos donde tenemos la instalación de nuestra versión Crosscompilada de GCC que compilamos
siguiendo las instrucciones en del artículo GCC Cross-compiler de osdev.
ASM=nasm
CROSS_DIR=~/opt/cross/bin
CC=$(CROSS_DIR)/i686-elf-gcc
AS=$(CROSS_DIR)/i686-elf-as
LD=$(CROSS_DIR)/i686-elf-ld
Luego seteamos los siguientes flags del compilador:
-
-m32le dice a GCC que genere código 32 bits. Es decir, registros generales en 32 bits (eax, ebx, ebp, esp, edi, esi, etc…), punteros de 32 bits, ABI de 32 bits, instrucciones compatibles con el modo protegido de 32 bits. -
-std=gnu99es la versión c99 del estándar C con extensiones GNU, del año 1999. -
-Ttext 0x10000flag de linker, le dice al linker que la sección.textcomienza en la dirección0x10000 -
-ffreestandingle decimos a GCC que no asuma que tenemos funciones estandar del runtime de C comomalloc(),printf(), etc… -
-fno-picdesactivamos Position Independent Code, con saber que todo el Kernel arranca en0x10000en adelante es suficiente. -
-fno-asynchronous-unwind-tablesy-fno-unwind-tablesdesactivamos la metadata que genera GCC para reconstruir excepciones, tracebacks, stacktraces, en caso de error. Reducimos el tamaño del binario con esto pero nos limitamos las capacidades para debuggear también. -
-march=i486reducimos el set de instrucciones bien atrás hasta 486 para evitar instrucciones avanzadas (onda, la instruciones de la familia pentium para arriba) limitando la compatibilidad con CPUs más viejas. Por ahora, tOSh corre a partir dei386. -
-Map kernel.mapes una opción del linker y nos sirve para crear un mapa de memoria y ubicar en que offsets está cada función y sección del binario
CCFLAGS= -m32 -std=gnu99 -Ttext 0x10000
CCFLAGS+= -ffreestanding -O0 -Wall -Wextra -fno-pic
CCFLAGS+= -fno-asynchronous-unwind-tables
CCFLAGS+= -fno-unwind-tables
CCFLAGS+= -march=i486 # avoid instructions like cmovna to be generated by gcc
LDFLAGS= -Map kernel.map
Finalmente definimos un Makefile estandar. No hay nada loco aca, tenemos .o, .map, y
algo especial que es nuestro archivo linker.ld.
KERNEL_SRC=$(wildcard kernel/*.c)
KERNEL_OBJS=$(KERNEL_SRC:.c=.o)
KERNEL_BIN=kernel.bin

all: kernel

clean:
	rm -rf *.bin
	rm -rf *.o
	rm -rf *.map
	rm -rf *.img
	rm -rf kernel/*.o
	rm -rf *.lst

%.o: %.c
	$(CC) -o $@ -c $< $(CCFLAGS)


kernel: $(KERNEL_OBJS)
		$(LD) -o $(KERNEL_BIN) $^ $(LDFLAGS) -Tkernel/linker.ld
El script del Linker
Cuando compilás, GCC genera unos archivos .o que contienen código y datos pero cada uno está pensado como un cacho independiente
del otro. Además, cada .o tiene varias secciones, como .text, .rodata, .bss, etc…
El linker lo que hace es agarrar todos esos .o que se generan al compilar uno o varios archivos .c y construye un programa
ubicando cada uno de esos Código OBJeto y posicionarlos decidiendo donde quedan exactamente cada uno de ellos en memoria.
Adicionalmente, resuelve referencias. Si la funcion pepito_delicioso() está programada en mi_libreria_de_pepitos.c, ese código
va a estar en mi_libreria_de_pepitos.o y si mi funcion kmain.c la llama, el linker se encarga de resolver esas referencia
a esa función.
El archivo linker.ld es un linker script y es un archivo que le dice al linker que no ubique los OBJ como se le cante,
sino más bien, vos le decís donde querés que ubique cada cosa en memoria. Definiendo secciones nuevas o donde empieza .text
uno tiene más control del layout de tu programa en memoria.
OUTPUT_FORMAT("binary")
/*ENTRY(kmain)*/
SECTIONS
{
    /* the start address of the kernel's .text section */
    . = 0x10000;

    .text BLOCK(4K) : ALIGN(4K)
    {
        /* *(.text.prologue) */

        /*
            set up the program entry point
            kmain.c should have only one function,
            and it's going to be the first section of code executed
            when jumping to the kernel.
            in the generated kernel.map file, kernel/kmain.o should be
            set at address 0x0000000000010000

            and void kmain(void); should be the first function written on top
            of the program
        */
        *(.text.kmain_entrypoint)

        /* and later on, all the kernel objects */
        *(.text)
    }

    .rodata BLOCK(4K) : ALIGN(4K)
    {
        *(.rodata)
    }

    .data BLOCK(4K) : ALIGN(4K)
    {
        *(.data)
    }

    .bss BLOCK(4K) : ALIGN(4K)
    {
        *(.bss)
    }

    .idt BLOCK(4K) : ALIGN(4K)
    {
        *(.idt)
    }

    .dma BLOCK(4K) : ALIGN(4K)
    {
        *(.dma)
    }

    end = .;
}
Al principio de todo, definimos OUTPUT_FORMAT(\"binary\"). Esto hace que el linker de gcc, no genere un archivo ejecutable .elf sino
un .bin directamente que no tiene ni headers, ni tablas, ni simbolos de debugging, nada. Un binario plano.
Nuestro Kernel no sabe nada de formatos binarios ni nada y si saltamos a un .elf el CPU va a ejecutar
los bytes del header del formato ELF crasheando el CPU.
Con . = 0x10000; dentro de SECTIONS le decimos a linker que empiece a ubicar los binarios a partir de esa dirección.
Esto apunta a .text, o sea que lo que le pasamos al Makefile donde le decimos donde empieza la seccion .text es redundante.
Despues, cada una de las secciones tienen que ser bloques y ademas estar alineados en "páginas de 4 kilobytes". Este tamaño, 4Kb, es el definido como página en x86. No solo las secciones tienen que estar en bloques de 4kb, sino que además tienen que estar alineados de a bloques de 4kb.
La primera sección ejecutable se llama: .text.kmain_entrypoint y lo que hacemos definiendolo asi es que sea cual fuere
la función en C que tenga este atributo, se le chanta ahi, que es la dirección de memoria 0x10000 que ya habíamos definido
y de esa manera nos aseguramos que esa funcion sea la primer función que se ejecute.
Si te fijás más arriba, en el código en C que presente primero, vas a ver arriba de kmain()el attributo que el linker
va a tomar del script para que sea lo primero que se ejecute de todo:
/*
0x10000 <-- arrancando en esta dirección de memoria
*(.text.kmain_entrypoint) <-- primero mete esta función
*(.text) <-- despues el resto de funciones
+-------------------------------+
| kmain_entrypoint              | <- PRIMERO
+-------------------------------+
| otras funciones .text         |
| configurar_cosas()            |
| contemplar_existencia()       |
| handlear_interrupciones()     |
| etc.                          |
+-------------------------------+
*/
__attribute__((section(".text.kmain_entrypoint")))
void kmain(void) { [...] }
Las secciones siguientes como .bss, .rodata y .data son estandard pero las que quedan no, son específicas del diseño de
mi Kernel.
La sección .idt la vamos a necesitar en un futuro cuando definamos la tabla de interrupciones de alguna manera como la siguiente:
    .idt BLOCK(4K) : ALIGN(4K)
    {
        *(.idt)
    }
__attribute__((section(".idt")))
struct idt_entry idt[256];
Lo mismo hacemos con la sección .dma que vamos a usar en un futuro también para guardar unos bùferes:
.dma BLOCK(4K) : ALIGN(4K)
{
    *(.dma)
}
__attribute__((section(".dma")))
uint8_t dma_buffer[...];
Entonces más o menos el layout de memoria del Kernel quedaría más o menos así:
0x10000

+--------------------------+
| .text                    |
|                          |
| kmain()                  | <- primera función de todas, el entrypoint
| fs_init()                |
| fs_read()                |
| idt_init()               |
| ...                      |
+--------------------------+
| .rodata                  |
| strings / constantes     |
+--------------------------+
| .data                    |
| variables inicializadas  |
+--------------------------+
| .bss                     |
| variables sin init       |
+--------------------------+
| .idt                     |
| IDT                      |
+--------------------------+
| .dma                     |
| DMA buffers              |
+--------------------------+
|                          |
| end                      |
+--------------------------+
La Gotita
Finalmente para unir y pegar con "La Gotita" todas las piezas del rompecabezas y tener una imagen para chantarle a qemu, bochs o una máquina real, necesitamos generar una imagen donde esté el bootloader, stage1 y el kernel y cada uno de sus binarios estén ubicados de manera tal el bootloader y el stage1 copien las cosas en memoria y que en el proceso de recompilar y programar, no se pisen los binarios entre si y estén lo suficientemente equiespaciados.
Para lograr esto, tuvimos que sentarnos con un papel y decir cuanto espacio suficiente siendo "suficiente" una variable que cambió bastante a lo largo del desarrollo de este Kernel. Más o menos este es mi layout del Floppy 3.5" 1.44MB que uso para meter el Sistema Operativo en él (update agosto 2026):
| Sectores | Offset | Contenido | Tamaño |
|---|---|---|---|
| 1 | 0x000000 |
Bootsector (boot.bin) |
512 B |
| 2–8 | 0x000200–0x000FFF |
Espacio reservado / Stage1 | hasta 7 sectores |
| 9–136 | 0x001000–0x10FFF |
Kernel (kernel.bin) |
hasta 128 sectores |
| 137–2880 | 0x11000–0x167FFF |
Filesystem / espacio restante | ~1.37 MB |
#!/bin/sh
echo "Cleaning up..."
make clean

echo "Compiling tOSh Kernel..."
make

kernel_size=$(stat -c %s kernel.bin)
kernel_sectors=$(( (kernel_size + 511) / 512 ))

MAX_KERNEL_SECTORS=128
KERNEL_FIRST_SECTOR=9
echo "kernel size: $kernel_size bytes, kernel sectors: $kernel_sectors"


if [ "$kernel_sectors" -gt "$MAX_KERNEL_SECTORS" ]; then
    echo "ERROR: kernel too large!"
    echo "Maximum: $((MAX_KERNEL_SECTORS * 512)) bytes"
    exit 1
fi

echo "Compiling bootsector and stage1..."
echo "taking into account the kernel size of $kernel_size bytes, which is $kernel_sectors sectors..."

echo "bootsector.asm -> boot.bin"
nasm -f bin bootsector.asm -o boot.bin


echo "Kernel first sector: $KERNEL_FIRST_SECTOR"

echo "stage1.asm -> stage1.bin with KERNEL_FIRST_SECTOR=$KERNEL_FIRST_SECTOR and KERNEL_SECTORS=$kernel_sectors"
nasm -D KERNEL_FIRST_SECTOR=$KERNEL_FIRST_SECTOR -D KERNEL_SECTORS=$kernel_sectors -f bin -l stage1.lst stage1.asm -o stage1.bin

stage1_size=$(stat -c%s stage1.bin)
stage1_sectors=$(( (stage1_size + 511) / 512 ))
echo "Stage1 size: $stage1_size bytes, $stage1_sectors sectors"

#nasm -f bin kernel/kernel.asm -o kernel.bin

echo "Creating floppy image..."
dd if=/dev/zero of=tOSh.img bs=512 count=2880

echo "Copying Bootsector at position 0, block 512 bytes..."
dd if=boot.bin of=tOSh.img conv=notrunc # copy the bootsector

echo "Copying stage1 at position 1, block 512 bytes..."
dd if=stage1.bin of=tOSh.img conv=notrunc bs=512 seek=1 # copy stage1

echo "Copying kernel at position $((KERNEL_FIRST_SECTOR -1)) (sector $KERNEL_FIRST_SECTOR), block 512 bytes..."
dd if=kernel.bin of=tOSh.img conv=notrunc bs=512 seek=$(($KERNEL_FIRST_SECTOR -1)) # copy kernel
Ejecutando este script de bash ./build.sh crea el sistema operativo en una imagen de floppy lista para ser booteada en una máquina
o un emulador. Hasta acá lo único que hacemos es escribir X en memoria (empezando por el mapping de VGA) hasta que la CPU crashea
por escribir fuera de los límites de memoria.
Este es el framework "básico" para poder empezara desarrollar un Kernel en C. A partir de ahora podemos seguir configurando la CPU, programarle drivers y aprovechar todas las bondades de un lenguaje de alto nivel como C abandonando así, el assembly.