¡Hasta aquí llegó el olor!
("Bis hierher ging der Geruch!" sagt das Spiel, wenn man "flor" ansagt - es reimt sich im Spanischen: flor / olor.)
Am Ende dieses Artikels habe ich den Link hinterlassen, damit du dir den Quellcode des "Kartenspions" ansehen kannst.
Das Truco Arbiser war ein Truco-Spiel, das zwischen Ende der 80'er und den 90ern
auf argentinischen Computern kursierte.
Man sagt, es sei nach MS-DOS das am meisten raubkopierte Programm gewesen.
Jahrelang habe ich unermüdliche Schlachten gegen den PC geschlagen und wurde bei jeder Partie unermüdlich beschimpft und verspottet.
Da es sich um ein Computerspiel handelt, hat meine Schlauheit nie ausgereicht, um zu gewinnen.
Aber damit ist jetzt Schluss. In diesem Artikel sehen wir, wie man dem Truco Arbiser ein Truco ansagt (bzw. einen Trick anwendet) und einen weiteren Sieg des Menschen über die Maschine einfährt.
Die Analyse
Um dem Truco Arbiser Tricks anzuwenden, müssen wir zuallererst wissen, womit es programmiert wurde.
 arbiser$ ls
BRUN40.EXE  MWYTRUC@.BAS  SIMCGA.COM  TRUCO.EXE      truco.zip
MVYTRUC@    MXYTRUC@      SIMCGA.DOC  truco.hexdump  VOZ.COM
$ hexdump -C TRUCO.EXE |grep -C5 -i BRUN
0000da00  3f ac cd 3f af cd 3f b0  cd 3f b7 cd 3f b8 cd 3f  |?..?..?..?..?..?|
0000da10  b9 cd 3f ba cd 3f c7 cd  3f c8 cd 3f c9 cd 3f ca  |..?..?..?..?..?.|
0000da20  cd 3f cf cd 3f d0 cd 3f  d4 cd 3f d5 cd 3f fe cd  |.?..?..?..?..?..|
0000da30  3f ff 00 cd 3f ff 01 cd  3f ff 02 cd 3f ff 06 cd  |?...?...?...?...|
0000da40  3f ff 0f cd 3f ff 10 cd  3f ff 11 cd 3f ff 12 cd  |?...?...?...?...|
0000da50  3f ff 13 cd 3f ff 14 00  3c 00 b1 42 52 55 4e 34  |?...?...<..BRUN4|
0000da60  30 2e 45 58 45 00 50 41  54 48 3d 75 11 00 b2 00  |0.EXE.PATH=u....|
0000da70  82 00 b0 bf e2 0d a1 02  00 2e a3 36 00 2b c7 3d  |...........6.+.=|
0000da80  00 10 72 03 b8 00 10 fa  8e d7 81 c4 9e 4d fb 96  |..r..........M..|
0000da90  9f 2e 88 26 38 00 96 83  e4 fe 03 c7 a3 02 00 8c  |...&8...........|
0000daa0  c3 2b d8 f7 db b4 4a cd  21 36 8c 1e 7d 00 a1 2c  |.+....J.!6..}..,|
--
0000de70  f5 1f 89 36 3f 00 c3 1e  06 1f 81 ff 55 00 74 12  |...6?.......U.t.|
0000de80  8a 45 ff 3c 3a 74 0b 3c  5c 74 07 3c 2f 74 03 b0  |.E.<:t.<\t.</t..|
0000de90  5c aa be 43 00 b9 0b 00  f3 a4 1f ba 55 00 b8 00  |\..C........U...|
0000dea0  3d cd 21 c3 b4 3e cd 21  72 01 c3 e9 be fc 00 45  |=.!..>.!r......E|
0000deb0  72 72 6f 72 20 69 6e 20  6c 6f 61 64 69 6e 67 20  |rror in loading |
0000dec0  42 52 55 4e 34 30 2e 45  58 45 20 52 54 4d 20 2d  |BRUN40.EXE RTM -|
0000ded0  20 24 4d 65 6d 6f 72 79  20 61 6c 6c 6f 63 61 74  | $Memory allocat|
0000dee0  69 6f 6e 20 65 72 72 6f  72 24 43 61 6e 6e 6f 74  |ion error$Cannot|
0000def0  20 66 69 6e 64 20 66 69  6c 65 20 69 6e 20 50 41  | find file in PA|
0000df00  54 48 24 44 69 73 6b 20  49 2f 4f 20 65 72 72 6f  |TH$Disk I/O erro|
0000df10  72 24 49 6e 76 61 6c 69  64 20 66 6f 72 6d 61 74  |r$Invalid format|
Nach einer sehr schnellen Suche und ein paar fabelhaften hexdumps stellen wir fest, dass die Datei BRUN40.EXE, die ebenfalls in dem Verzeichnis liegt,
in dem sich das Spiel befindet, vorhanden ist.
Diese Datei ist die runtime-Bibliothek von Programmen, die mit QuickBasic kompiliert wurden,
einem Compiler für die Programmiersprache BASIC, entwickelt von Microsoft.
Die genaue Version dieser runtime ist 4.0. Ab jetzt
nenne ich QuickBasic 4.0 einfach QB4.
QB4 besteht aus zwei Sprachprozessoren. Der erste, QB.EXE,
stellt eine interaktive Entwicklungsumgebung bereit. Es ist ein
inkrementeller Compiler, der den Quellcode in threaded p-code umwandelt und
dann den p-code interpretiert ausführt.
Der andere, BC.EXE, ist ein Kommandozeilen-Compiler,
der native ausführbare Dateien erzeugt.
threaded p-code ist eine Art Virtual Machine. Wie zum Beispiel die JVM. Der als threaded p-code erzeugte Code ist ein byte code als Zwischenschritt, der entweder vom QB4-Interpreter oder
von der BRUN40.EXE-Runtime interpretiert wird.
Jeder dieser Compiler hat gewisse Vorteile und sie können
je nach Bedarf eingesetzt werden.
Der p-code-Interpreter verliert an Ausführungsgeschwindigkeit, gewinnt dafür aber
an Kompilier-Geschwindigkeit. Das ermöglichte eine viel
schnellere Entwicklung. Denken wir daran, dass das Truco Arbiser in den
80ern entwickelt wurde; ich nehme an, auf einem XT oder höchstens einem 286, angesichts der Art von Computern,
die es in jener Zeit gab, und ihrer Preise.
Außerdem nehme ich an, dass die Version, die man von der Seite des
Truco Arbiser herunterladen kann, die Version von 86 (oder 87)1 ist, wo erwähnt wird,
dass sie auf derselben Seite "neu kompiliert" wurde, wegen des
Titelbildschirms, und weil ich keine Möglichkeit gefunden habe, die Sprachausgabe zum Laufen zu bringen,
obwohl die Datei VOZ.COM im Zip der Seite enthalten ist. Ich sage das, weil auf der Seite des Truco Arbiser erwähnt wird, dass das Sprachmodul 1992 im Auftrag einer Firma entwickelt wurde.
Die Idee war also, sehr schnell mit p-code zu entwickeln und
danach den BC-Compiler zu benutzen, um die endgültige ausführbare Datei zu erzeugen,
ohne dass der Interpreter beteiligt sein muss.
Aber aber aber, der Nachteil dieser Entwicklungsmethode ist, dass
jeder Compiler anderen Code erzeugt. p-code != asm x86.
Ein Programm, das im QB4-Interpreter einwandfrei läuft, läuft
wunderbar, aber beim Kompilieren zu Maschinencode konnten einige Unterschiede
in der Interpretation auftreten, und das "fertige" Programm stürzte ab.
Man sollte bedenken, dass diese Optimierung zwischen Interpreter und "Endkompilierung" notwendig war, weil der iterative Softwareentwicklungsprozess in dieser Zeit so langsam war. Die Ressourcen waren begrenzt und diese Lösungen halfen enorm, die Dauer des Entwicklungszyklus zu verkürzen.
Als Zwischenfazit haben wir also:
- Die verfügbare Version des Truco Arbiser 5.4 hat ein Copyright von 1986 und wurde mit QB4 kompiliert, also 1987 oder später1. Die ausführbare Datei zeitlich einzuordnen ist wichtig, es hilft uns, die möglichen Versionen der damals verwendeten Compiler für eine spätere Analyse einzugrenzen.
- Das Vorhandensein von
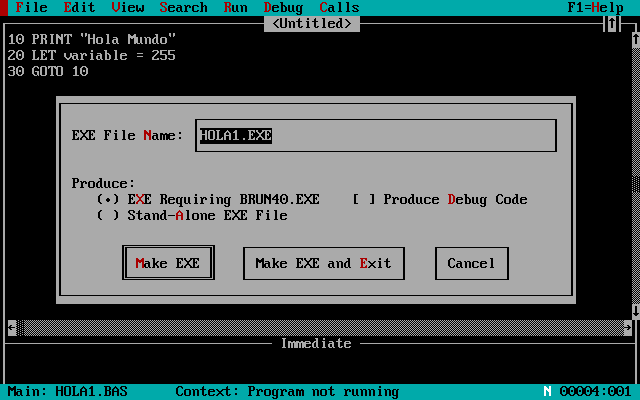
BRUN40.EXEgrenzt die Möglichkeiten noch weiter ein. Es hilft mir anzunehmen, dass das Programm mitQB4kompiliert wurde und zwar nicht als eigenständige ausführbare Datei, sondern dass beim Kompilieren die OptionEXE Requiring BRUN40.EXEverwendet wurde. - Das Vorhandensein von
BRUN40.EXEin der ausführbaren Datei deckt sich mit meinen Beobachtungen. - Ein auf diese Weise kompiliertes Programm lässt sich nicht einfach disassemblieren, da eine "VM" dazwischen liegt.
Das Problem
Das Problem besteht nicht nur darin, dass die ausführbare Datei eine runtime braucht,
um die byte-codes des kompilierten Programms zu interpretieren, sondern auch darin,
dass wir absolut nichts über das Format der ausführbaren Datei wissen, weder wie
die Bytes interpretiert werden, noch wie die Informationen
in der Datei strukturiert und verteilt sind.
Wir können annehmen, dass am Anfang der Datei ein header steht, der von MSDOS eingelesen wird, dass irgendwo die Strings abgelegt sind und
dass irgendwo anders der p-code liegt, falls alles
was wir bisher gesagt haben stimmt.
In diesem Artikel übergehe ich mehrere Versuche, das Disassemblierungsproblem
aus verschiedenen Blickwinkeln anzugehen. Alle gescheitert, natürlich.
Ich habe versucht, das Truco Arbiser mit IDAPro zu disassemblieren, angehängt an einen
Debugger, der mit einer speziellen Version von DOSBOX verlinkt war, und das ist nicht nur
instabil, sondern alle naslang taucht ein Interrupt des Prozessors auf
und unterbricht den Hauptfluss der Programmausführung, was es unverfolgbar macht.
Was ich nach langem Debuggen gelernt habe, ist, dass es eine Tabelle
von CALLS gibt, die auf NULL zeigen und zur runtime gepatcht werden, während
das Programm läuft. Das bedeutet, dass QB4 ausführbare Dateien erzeugt,
die sich selbst modifizieren; was das Debuggen enorm viel schwieriger macht.
Ich habe auch versucht, mit dem Turbo Debugger zu debuggen, mit besseren
Ergebnissen, aber da er viel Speicher verbraucht (640k ftw!), bin ich auch damit nicht
sehr weit gekommen, weil das Programm entweder mit einem out of memory abbrach oder einfach abstürzte und zufällige Zeichen auf
dem Bildschirm zeigte.
Wenn ich von "weit kommen" spreche, meine ich, dass ich nach mehreren
Iterationen des Parsens von p-code und Patchens von Speicheradressen nie auch nur die Funktion erreicht habe, die den Titelbildschirm des Spiels anzeigt.
Es gibt die Möglichkeit, zwei dosbox-Instanzen über seriell zu verbinden,
den Turbo Debugger und das Programm getrennt laufen zu lassen, das Programm irgendwo aus der Ferne zu unterbrechen und von dort aus zu debuggen, aber an diesem Punkt war ich frustriert und als ich Artikel über diese Methode las, hat es mir ziemlich
die Laune verdorben, dass sich in den Foren alle beschwerten, diese Art zu debuggen
sei so langsam.
Kurzum, der Weg über das Debuggen kostet so viel Zeit, dass er in diesem Fall unpraktikabel ist.2
P-Code-Disassembler
Da kam mir die Idee: Was ist, wenn ich statt zu debuggen einen Disassembler schreibe? 2 Bevor ich ihn schrieb und diesen Weg einschlug, habe ich natürlich im Interwebz gesucht, ob das schon jemand gemacht hatte. Es gibt einige Teillösungen und einen Herrn, der in Großbritannien zwischen 350 und 5000 Pfund Sterling verlangt und einen Disassemblierungsservice anbietet. Zahlen kommt offensichtlich nicht in Frage. Mit diesem neuen Fokus machte ich mich also an die Arbeit.
Die offensichtlichen Dinge
Wir werden in unseren Tests versuchen, Dinge so zu kompilieren, wie die Arbisers es damals
vielleicht getan haben.
Die Idee dahinter ist zu sehen, wie sich die kompilierte ausführbare Datei
auf Binärebene bei kleinen Variationen im BASIC-Programm
verhält.
Zuerst schreiben wir also ein ganz einfaches Programm:
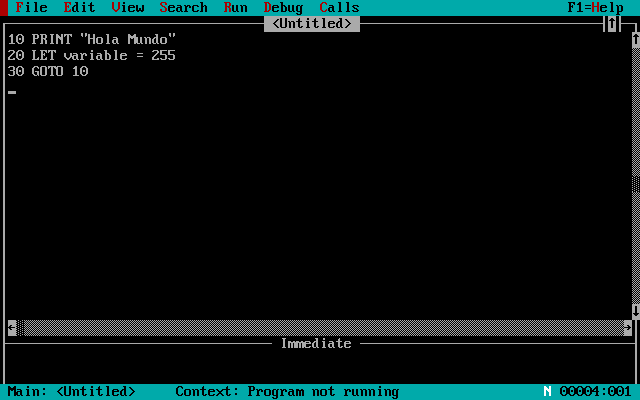
Und wir kompilieren es mit dem, was wir darüber gelernt haben, wie die Konfiguration der Arbisers damals gewesen sein könnte, anhand der Informationen, die wir in den vorherigen Abschnitten analysiert haben.
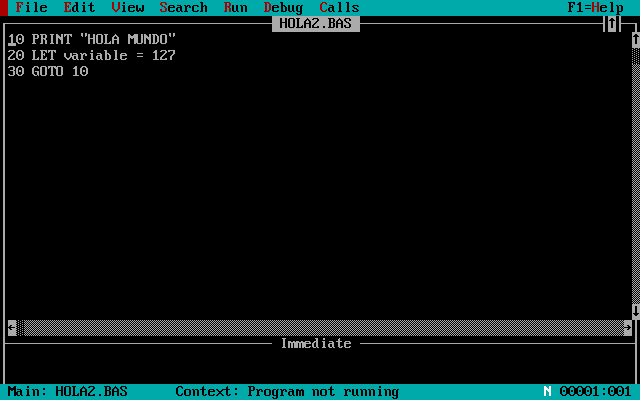
Und wir kompilieren eine zweite Version mit diesem Quellcode
IEEE 754
Ihr werdet merken, dass die Unterschiede zwischen den beiden BASIC-Programmen sehr klein sind.
Nach diesen Änderungen machen wir einen binären Diff der beiden
ausführbaren Dateien und vergleichen, was sich zwischen ihnen geändert hat:
 $ diff  <(xxd HOLA1.EXE) <(xxd HOLA2.EXE)
33c33
< 00000200: 626d 484f 4c41 3120 2020 0000 6218 3018  bmHOLA1   ..b.0.
---
> 00000200: 626d 484f 4c41 3220 2020 0000 6218 3018  bmHOLA2   ..b.0.
162,163c162,163
< 00000a10: b200 6017 b00a 0044 1848 6f6c 6120 4d75  ..`....D.Hola Mu
< 00000a20: 6e64 6f00 007f 4312 00b2 000e 00b0 ffff  ndo...C.........
---
> 00000a10: b200 6017 b00a 0044 1848 4f4c 4120 4d55  ..`....D.HOLA MU
> 00000a20: 4e44 4f00 00fe 4212 00b2 000e 00b0 ffff  NDO...B.........
Abgesehen von der Änderung des Dateinamens sieht man, dass der String anders ist, und bei 0x0a25 ändert sich ein Word, bei dem ich annehme, dass es die Variable mit dem Wert 127 bzw. 255 ist. Das Interessante ist, dass auf den ersten Blick nicht klar ist, wie 255 mit 0x7f43 und 127 mit 0xfe42 dargestellt wird.
Nachdem man diese Zahlen eine Weile angestarrt hat, merkt man leicht,
dass es gar keine words sind, sondern doublewords, und dass
das Format dieser Zahlen IEEE 754 ist. Ich habe mehrere
Zahlen verglichen, die in einer neuen ausführbaren Datei mit folgendem Code erzeugt wurden:
LET variable = 2
LET variable = 3
LET variable = 4
LET variable = 5
LET variable = 6
LET variable = 7
LET variable = 8
LET variable = 9
LET variable = 0
LET variable = -2
LET variable = -3
LET variable = -4
LET variable = -5
LET variable = -6
Unten kannst du die dword-Werte sehen, die durch diese Variablenzuweisungen erzeugt wurden.
Du kannst diese dwords selbst mit einem IEEE 754-Rechner vergleichen, wenn du magst:
 $ hexdump -C HOLA5.EXE  |grep -A5 ab0
00000ab0  b2 00 60 17 b0 0a 00 44  18 48 4f 4c 41 20 4d 55  |..`....D.HOLA MU|
00000ac0  4e 44 4f 00 00 00 40 00  00 40 40 00 00 80 40 00  |NDO...@..@@...@.|
00000ad0  00 a0 40 00 00 c0 40 00  00 e0 40 00 00 00 41 00  |..@...@...@...A.|
00000ae0  00 10 41 00 00 00 00 00  00 00 c0 00 00 40 c0 00  |..A..........@..|
00000af0  00 80 c0 00 00 a0 c0 00  00 c0 c0 46 00 b2 00 0a  |...........F....|
00000b00  00 b0 ff ff 01 03 00 b2  00 25 00 b0 4f 00 0f 00  |.........%..O...|
Ein Beispiel: Der Wert -5 in IEEE 754-Darstellung am Offset 0xaf3 ist 0xc0a00000.
All diese Erklärungen setzen voraus, dass wir bereits einen vom Compiler erzeugten Datentyp interpretieren können.
Header erkennen
Alles sehr schön, aber was nützt es zu wissen, wie man ein paar
doubles in der Binärdatei interpretiert, wenn wir nicht einmal wissen, in welchem Abschnitt wir sie suchen müssen?
Hier wird es richtig schön, denn schon bei einfacher Betrachtung
einer von QB4 erzeugten ausführbaren Datei sehen wir, dass es nicht
nur einen, sondern zwei Header gibt.
Der erste ist offensichtlich der Header einer .EXE, aber der
zweite ist auf den ersten Blick nicht so leicht zu erkennen, auch wenn man ihn mit geübtem
Auge sieht, wenn man ihn anstarrt. Ganz lange.
 $ hexdump -C HOLA5.EXE  |grep -A5 HOLA5
00000200  62 6d 48 4f 4c 41 35 20  20 20 00 00 92 18 30 18  |bmHOLA5   ....0.|
00000210  40 18 00 00 00 00 00 00  30 18 00 00 00 00 00 00  |@.......0.......|
00000220  40 18 0a 00 00 00 00 00  00 00 00 00 ff ff 80 00  |@...............|
00000230  b8 40 18 50 9a 52 01 0f  00 cd 35 06 4e 18 cd 35  |.@.P.R....5.N..5|
00000240  1e 36 18 cd 3d cd 35 06  52 18 cd 35 1e 36 18 cd  |.6..=.5.R..5.6..|
00000250  3d cd 35 06 56 18 cd 35  1e 36 18 cd 3d cd 35 06  |=.5.V..5.6..=.5.|
Ich vermute, dass am Offset 0x200 das erste Word eine Art Kennung
ist, die folgenden 8 Bytes (verdächtigerweise mit
Leerzeichen aufgefüllt) der Dateiname sind, und danach mehrere Bytes
mit unbekannten Werten kommen, bis irgendetwas beginnt, das entweder
Code oder Daten ist.
/* bm header */
typedef struct {
    char        id[2];             // bm for BRUN modules
    char        module_name[8];
    uint16_t    sat;           // Statament Address Table
    uint16_t    ds;            //
    uint16_t    data;          // BC_DATA
    uint16_t    ft;
    uint16_t    icn;           // base for icn
    uint16_t    inc;           // base for INIT
    uint16_t    dsg;           // base for DATA (runtime DATA)
    uint16_t    com;           // offset for common
    uint16_t    sz_com;        // size for common
    uint16_t    uconst;        // offset for user const
    uint16_t    udata;         // user data
    uint16_t    cn;
    uint16_t    sz_frame;
    uint16_t    alloc;         // offset heap allocation routine for ISAM
    uint16_t    seg_alloc;     // segment heap allocation routine
    uint16_t    off_dealloc;   // offset heap deallocation routine for ISAM
    uint16_t    seg_dealloc;   // segment heap deallocation routine
    int16_t     c_switch;      // value of /C:n switch, -1 if not given
    uint16_t    u_flag;        // switches specified at compile time

} bm_hdr;
Andere Wege gehen
BC.EXE, der QuickBasic Compiler, hat mehrere Flags,
die man beim Kompilieren als Parameter übergeben kann.
Einer dieser Parameter ist /a, der zusätzlich zum Kompilieren des
Programms auch eine "Auflistung" in einem Assembler erzeugt,
der auf halbem Weg zu reinem Maschinencode ist.
Ein Beispiel, das folgende BASIC-Programm, das ich FOR.BAS genannt habe:
n = 0
FOR x = 1 TO 16:
     n = (n + 1) * x
     PRINT "N ahora es:", n
NEXT x
Erzeugt mit dem Flag /a die folgende Datei FOR.LST:
                                                                      PAGE   1
                                                                      24 Feb 22
                                                                      16:25:51
Offset  Data    Source Line     Microsoft (R) QuickBASIC Compiler  Version 4.00

 0030   0006    n = 0
 0030   0006    FOR x = 1 TO 16:
 0030    **            I00002: int   35h
 0032    **                    db    06h
 0033    **                    dw    <00000000>
 0035    **                    int   35h
 0037    **                    db    1Eh
 0038    **                    dw    N!
 003A    **                    int   3Dh
 003C    **                    int   35h
 003E    **                    db    06h
 003F    **                    dw    <0000803F>
 0041    **                    jmp   I00003
 0044   000A         n = (n + 1) * x
 0044   000A         PRINT "N ahora es:", n
 0044   000A    NEXT x
 0044    **            I00004: int   35h
 0046    **                    db    06h
 0047    **                    dw    N!
 0049    **                    int   34h
 004B    **                    db    06h
 004C    **                    dw    <0000803F>
 004E    **                    int   34h
 0050    **                    db    0Eh
 0051    **                    dw    X!
 0053    **                    int   35h
 0055    **                    db    1Eh
 0056    **                    dw    N!
 0058    **                    int   3Dh
 005A    **                    mov   ax,offset <const>
 005D    **                    push  ax
 005E    **                    call  B$PCSD
 0063    **                    push  N!+0002h
 0067    **                    push  N!
 006B    **                    call  B$PER4
 0070    **                    int   35h
 0072    **                    db    06h
 0073    **                    dw    X!
 0075    **                    int   34h
 0077    **                    db    06h
 0078    **                    dw    <0000803F>
 007A    **            I00003: int   35h
 007C    **                    db    1Eh
 007D    **                    dw    X!
 007F    **                    int   3Dh
 0081    **                    int   35h
 0083    **                    db    06h
 0084    **                    dw    <00008041>
 0086    **                    int   35h
 0088    **                    db    06h
 0089    **                    dw    X!
 008B    **                    int   3Dh
 008D    **                    call  B$FCMP
 0092    **                    jna   $-50h

                                                                      PAGE   2
                                                                      24 Feb 22
                                                                      16:25:51
Offset  Data    Source Line     Microsoft (R) QuickBASIC Compiler  Version 4.00

 0094   000E
 0094   000E
 0094   000E
 0094   000E
 0094    **                    call  B$CENP
 0099   000E

44108 Bytes Available
43555 Bytes Free

    0 Warning Error(s)
    0 Severe  Error(s)
Und schließlich der relevante Abschnitt der Binärdatei FOR.EXE:
00000200  62 6d 46 4f 52 20 20 20  20 20 00 00 72 18 30 18  |bmFOR     ..r.0.|
00000210  44 18 00 00 00 00 00 00  30 18 00 00 00 00 00 00  |D.......0.......|
00000220  50 18 0a 00 00 00 00 00  00 00 00 00 ff ff 80 00  |P...............|
00000230  cd 35 06 50 18 cd 35 1e  36 18 cd 3d cd 35 06 54  |.5.P..5.6..=.5.T|
00000240  18 e9 36 00 cd 35 06 36  18 cd 34 06 54 18 cd 34  |..6..5.6..4.T..4|
00000250  0e 3a 18 cd 35 1e 36 18  cd 3d b8 58 18 50 9a 40  |.:..5.6..=.X.P.@|
00000260  01 0a 00 ff 36 38 18 ff  36 36 18 9a 4c 01 0a 00  |....68..66..L...|
00000270  cd 35 06 3a 18 cd 34 06  54 18 cd 35 1e 3a 18 cd  |.5.:..4.T..5.:..|
00000280  3d cd 35 06 68 18 cd 35  06 3a 18 cd 3d 9a 34 02  |=.5.h..5.:..=.4.|
00000290  0a 00 76 b0 9a 13 00 0a  00 00 00 00 00 00 00 00  |..v.............|
000002a0  00 00 00 00 00 00 00 00  00 00 00 00 00 00 00 00  |................|
Ab 0x230 sieht man, dass jeder Opcode mit der Auflistung
FOR.LST übereinstimmt!
Das würde bedeuten, dass es zum Parsen zumindest dieses Abschnitts
der Binärdatei (theoretisch) genügen würde, jedes der
Tokens der Sprache mit seiner Auflistung und seiner binären Darstellung zu verknüpfen.
Eine riesige Tabelle mit allen Kombinationen der
Anweisungen der Sprache anlegen, Typen und Ausdrücke identifizieren und
langsam versuchen, jede Bytefolge zu etwas zu rekonstruieren, das dem
Code des ursprünglichen Programms ähnelt.
Manche Dinge lassen sich nicht rekonstruieren, wie die Namen von
Variablen - die am Ende nur Verweise auf Offsets sind -
oder die Labels, die benutzt wurden, um Namen von Funktionen
oder Sprungziele zu definieren.
Wenn das vernünftig ist, könnte man den ursprünglichen Code des Truco Arbiser teilweise rekonstruieren und, sobald wir den Code einigermaßen disassembliert haben, könnten wir ihn analysieren, um danach seine Geheimnisse zu lüften.
Einen Parser schreiben und Tokens interpretieren
Funktionsnamen finden
Wenn wir ein LST erzeugen, gibt uns der Microsoft-Compiler bei jedem call-Opcode
die vom Runtime verwendete Bezeichnung
zum Beispiel so an:
 [...] (Ausschnitt aus FOR.LST)
 005A    **                    mov   ax,offset <const>
 005D    **                    push  ax
 005E    **                    call  B$PCSD
 0063    **                    push  N!+0002h
 0067    **                    push  N!
 006B    **                    call  B$PER4
 [...]
Wenn wir die Opcodes parsen, schaue ich bei jedem call auf die Adresse,
die aufgerufen wird, und vergleiche das LWORD,
wobei ich das HWORD verwerfe. Das mache ich auf
willkürliche Weise, da es im Moment ziemlich
gut funktioniert. Ich weiß noch nicht genau, was HWORD
darstellt:
    [...] Ausschnitt aus bm_get_call_mnemonic(char*)

    uint16_t current_lword = (uint16_t)(current_dword & 0xffff);

    switch (current_lword) {
    [...]
        case 0x0140:
            strcpy(&func_name, "B$PCSD - Print a$,");
        break;

        case 0x014c:
            strcpy(&func_name, "B$PER4 - Print R4 (Single precision real (sp))");
        break;
    [...]
Und hier unten zeige ich, wie mein Disassembler die Funktionsnamen erkennt und dabei ein bisschen mehr Informationen anzeigt, die beim Debuggen nützlich sind, während ich ihn programmiere:
0x025a		mov	ax, offset 0x1858
0x025d		push	ax
0x025e		call	B$PCSD - Print a$,	<0x000a0140>
0x0263		push	<0x1838> (modr:0x36)
0x0267		push	<0x1836> (modr:0x36)
0x026b		call	B$PER4 - Print R4 (Single precision real (sp))	<0x000a014c>
Dieser und andere Prozesse sind ziemlich mühsam, denn das Problem ist nicht, die Aufrufe jeder Funktion der Runtime einzeln zuzuordnen, sondern dass ich, um immer mehr Funktionen zu finden, die andere Funktionen aufrufen, iterativ BASIC-Programme schreiben muss, die sich ausreichend voneinander unterscheiden, damit der Compiler jede dieser Funktionen aufruft.
Das bedeutet: Je mehr
Programme ich schreibe, desto mehr Funktionen finde ich dank
des vom Compiler erzeugten LST, aber
gleichzeitig muss ich immer kreativer mit der "Funktionalität"
der Programme sein, damit mir der Compiler die
Funktionsaufrufe zeigt.
Das kostet enorm viel Zeit. Da das Ziel ist,
dem Truco Arbiser Truco anzusagen, versuche ich nicht,
ALLES zu mappen, was der Compiler von
QuickBasic 4.0 ausgibt, sondern eher Dinge zu programmieren,
die - mit etwas Raten - die Arbisers
beim Programmieren des Spiels gebraucht haben könnten.
Gleitkomma-Emulation
Ah! Das ist ziemlich schwierig und stellte mich vor eine Herausforderung, als ich versuchte, die "Gleitkomma"-Opcodes zu verstehen und zu parsen.
Ich setze es in Anführungszeichen, weil QB4 in Wahrheit
nicht genau FPU-Opcodes verwendet,
sondern eine Art Emulation, die wie folgt definiert ist:
INT 34 - FLOATING POINT EMULATION - OPCODE D8h
INT 35 - FLOATING POINT EMULATION - OPCODE D9h
INT 36 - FLOATING POINT EMULATION - OPCODE DAh
INT 37 - FLOATING POINT EMULATION - OPCODE DBh
INT 38 - FLOATING POINT EMULATION - OPCODE DCh
INT 39 - FLOATING POINT EMULATION - OPCODE DDh
INT 3A - FLOATING POINT EMULATION - OPCODE DEh
INT 3B - FLOATING POINT EMULATION - OPCODE DFh
INT 3C - FLOATING POINT EMULATION - SEGMENT OVERRIDE
INT 3D - FLOATING POINT EMULATION - STANDALONE FWAIT
INT 3E - FLOATING POINT EMULATION - Borland "SHORTCUT" CALL
Ergibt Sinn. Damals war eine FPU optional: Man konnte in seinen Computer eine FPU einbauen oder nicht
und alle Gleitkomma-Operationen gingen dann den Bach runter, oder man konnte
sich dafür entscheiden, diese Operationen nur mit der CPU zu emulieren, was die Berechnungen erheblich
langsamer machte.
Bis ich zu dieser Liste kam und wusste, wofür ich sie brauchte, verging ziemlich viel Zeit. Schauen wir uns das folgende Stück Disassembly an:
BASIC:
LET variable = 2
LET variable = 3
LET variable = 4
LET variable = 5

QuickBasic .LST:
 0039    **                    int   35h
 003B    **                    db    06h
 003C    **                    dw    <00000040>
 003E    **                    int   35h
 0040    **                    db    1Eh
 0041    **                    dw    VARIABLE!
 0043    **                    int   3Dh
 0045    **                    int   35h
 0047    **                    db    06h
 0048    **                    dw    <00004040>
 004A    **                    int   35h
 004C    **                    db    1Eh
 004D    **                    dw    VARIABLE!
 004F    **                    int   3Dh
 0051    **                    int   35h
 0053    **                    db    06h
 0054    **                    dw    <00008040>
Es gibt also eine Beziehung zwischen den INTerrupts,
den dbs und den dws, die in der Binärdatei Offsets waren, und
den LST-Nummern des Compilers. Offensichtlich wurden
die ganzen Zahlen des Originalprogramms auf besondere Weise kodiert, bis es mir irgendwann dämmert und ich sage: Natürlich! IEEE754! 3
Nach und nach beginnen die Teile des Puzzles Form und Sinn anzunehmen. Das Problem ist, dass es unglaublich viele Teile gibt und man sich leicht zwischen so vielen Bytes und losen Daten verliert, wenn man versucht, ihnen einen Sinn zu geben.
Offsets und Blöcke
Wie sind die Abschnitte des Moduls der ausführbaren Datei organisiert? Wie berechne ich, wo all die Dinge liegen, auf die die Binärdatei verweist? An welchem genauen Offset werden die Variablen, die Konstanten, die Strings usw. gespeichert?
Keine Ahnung, noch nicht :D
B$<funcname>
Plötzlich erfahre ich, dass es einen Leak von msdos 6.0 gab, und damit konnte ich einige der wichtigsten Teile dieses Puzzles vervollständigen.
Es stellt sich heraus, dass es im Verzeichnis 45/runtime/rt jede Menge Definitionen von runtime-Aufrufen gibt, aus denen ich einen Teil der
Dokumentation übernehmen, den Offset der Runtime finden und für jeden
Aufruf den Namen der Funktion und eine kurze Beschreibung ihrer Aufgabe ausgeben kann:
    [...]
        case 0x0185:
            strcpy(&func_name, "B$SASS - String assignment");
        break;

        case 0x00f5:
            strcpy(&func_name, "B$INPP -- console input preamble");
        break;

        case 0x0170:
            strcpy(&func_name, "B$RDSD -- console input read String Descriptor");
        break;
    [...]
Das Vorgehen ist:
- Ein
BASIC-Programm kompilieren -
BC.EXEbitten, uns ein.LSTzu erzeugen - Die
calls zur Runtime nehmen und die Definition im Quellcode von msdos6.0 nachschlagen - Die Doku lesen und die Definition des Call-Offsets in meinem Disassembler hinterlegen (den ich mit dem Schlüsselwort
unknownmarkiere, falls ich ihn nicht geparst habe)
Diese Schritte kosten unglaublich viel Zeit, und im Juni (2022) war ich an diesem Punkt der Entwicklung schon seit mehreren Monaten dabei, nur das in meiner Freizeit zu tun. Und ich begann zu denken, dass der Weg nicht hierüber führt.
Eine unerwartete Wendung
Diese Arbeitsweise ist ziemlich puristisch, und manchmal habe ich beim Programmieren viel Spaß, und Dinge zu tun, die schwer genug sind, wie ein Disassembler von Grund auf mit C und den Intel-Handbüchern, macht fantastisch viel Spaß, aber der Fortschritt des Projekts wird viel zu langsam. Eine Zeit lang, bis hierher (ungefähr ein paar Monate), baute ich meinen eigenen Disassembler, und die Aufgabe wurde schließlich, den Disassembler zu schreiben, anstatt zu versuchen, die ausführbare Datei mit einem Werkzeug zu disassemblieren, das das viel besser kann, als wenn ich es selbst schreibe.
Irgendwann wurde die Arbeit, einen Disassembler von Grund auf zu schreiben, lächerlich mühsam und verschlang zu viel Zeit. Deshalb beschloss ich, den Kurs des Projekts komplett zu ändern und eine Disassemblierungs-Engine zu verwenden, um das Mapping der Funktionsaufrufe auf die QB-Runtime so weit wie möglich zu automatisieren.
Ich entschied mich, auf die Capstone Engine zu setzen und den Vergleich von segment:offset jedes CALL mit den Listings, die der QB4-Compiler ausspuckt, zu automatisieren und sie mit meinem Disassembler abzugleichen.
Im Wesentlichen:
- Offsets mit lcall/call-Paaren interpretieren und vergleichen und dabei die Strings der Funktionsaufrufe aktualisieren.
- Eine Tabelle der Funktionen aufbauen, die ich bereits entdeckt habe
- rinse and repeat ad infinitum
All diese Mühe trug gewisse Früchte. Ich konnte irgendwie Teile von Programmen disassemblieren, die mit Quick Basic 4.0 kompiliert wurden, unter Verwendung seiner runtime, und irgendwann würde ich einen Señor Disassembler haben, der in Zukunft nützlich sein könnte, um alte Programme zu disassemblieren, à là HexRays.
Irgendwie ist es so, dass man nie etwas fertigstellt, oder? Die Reise ist es, was unterhält, und auf dieser Reise habe ich unglaublich viel gelernt. Das Endziel war, Truco auf das Truco anzuwenden (Truquear al Truco), und ich bin darin abgeschweift, eine ganze P-Code-Disassemblierungs-Suite zu bauen.
Im Jahr darauf (2023), als ich etwas Brauchbares hatte, entwischte mir das Arbiser wieder und ich konnte der CPU immer noch nicht in die Karten schauen, was das Hauptziel war. Als ich das verstanden hatte, fing ich wieder mit IDA an und mit dem Reversen, dort, wo ich ursprünglich angefangen hatte.
Dieser Weg würde mich schließlich dazu bringen, es zu knacken, und der Weg führte hierüber.
Analyse von Strukturen im Speicher
Das Thema mit den Interrupts, das mich so schnell das Handtuch werfen ließ, war nur eine Frage der Ungeduld. Ich weiß nicht mehr, wie ich es gelöst habe, aber wenn es keine Einstellung war, lag ich verdammt nah dran. Was ich anfing zu tun, waren nur Lese- und Schreib-Breakpoints, getrennt voneinander. Zusätzlich führte ich eine Liste interessanter Speicheradressen oder von Stellen, an denen relevant aussehende Funktionen beginnen.
Ein Jahr später mache ich mich also ans Reversen und komme zu einer ordentlichen Tabelle, um einige lohnenswerte Breakpoints zu setzen:
| segment:offset Speicher | segment:offset disassembliert | Länge | Beschreibung |
|---|---|---|---|
| seg004:fa94 | [si+1c72] | WORD*6 + 1 | Spieler-Words, Farbe 1 Farbe 2 Farbe 3 – nichts – Karte 1, 2, 3 |
| seg004:f66a | [si+1848] | WORD*6 + 1 | Computer-Words, Farbe 1 Farbe 2 Farbe 3 – nichts - Karte 1, 2, 3 |
| seg004:f680 | [si+1860] | WORD*3 | Platzhalter/Speicherbereich für Zufallszahlen |
| seg004:fae4 | ds:1cc4 | WORD | Zufallszahl |
| seg004:fb90 | ds:1d70 | WORD | current_card, die für den Spieler berechnet wird |
| seg004:fb92 | ds:1d72 | WORD | current_card, die für den Computer berechnet wird |
| seg004:fb02 | ds:1ce2h | WORD | zuletzt verarbeitete Kartennummer (Spieler) |
| seg004:fb04 | ??? | DWORD | ??????????????????????????? |
| seg004:fb06 | ??? | DWORD | ??????????????????????????? |
| seg004:fb08 | ??? | DWORD | ??????????????????????????? |
| seg004:fb0a | ??? | WORD | zuletzt verarbeitete Farbe (Spieler) |
| seg005:12d3 | ds:2836-ds:283a | WORD | STACK! BP/SP in seg005, ist die Zahl, die AX für viele Operationen im Zusammenhang mit den Zufallsfunktionen erhält |
| 021e:e6fb | ds:8db | WORD | Low WORD des vorherigen PRNG-Seeds |
| 021e:e6fd | ds:8dd | WORD | Hi WORD des vorherigen PRNG-Seeds |
| ???? | 021e:e020 | WORD | A Konstante QB4.0 PRNG |
| ???? | 021e:e024 | BYTE | C Konstante QB4.0 PRNG |
| ???? | 021e:de20 | DWORD | Gleitkomma-Speicherbereich? |
Farben (Palos):
| Farbe | EQU |
|---|---|
| Espada (Schwerter) | 0x0000 |
| Basto (Stäbe) | 0x0001 |
| Oro (Münzen) | 0x0002 |
| Copa (Kelche) | 0x0003 |
Ich habe außerdem einige wichtige Details im Binärcode und seinen Datenstrukturen entdeckt:
- die Kartenwerte reichen von 0x0001 bis 0x000A (1 bis 10, 1234567,10,11,12 sind 10 verschiedene Kartennummern)
- wenn die ausgewählte Karte größer als 7 ist, addieren wir 2, um so zu korrigieren, wie sie tatsächlich aussehen müssen.
- es gibt einen Speicherbereich, in dem die Karten des Spielers und der CPU liegen, und alle Lesezugriffe dienen tendenziell dazu, sie auf dem Bildschirm zu zeichnen, die Schreibzugriffe stammen vom Algorithmus zum Austeilen der Karten
Super, ungefähr zu wissen, was was bedeutet! Die Knobelei ist jetzt zu verstehen, wie diese Werte berechnet werden und woher sie kommen. Wenn wir das wissen, könnten wir das Verhalten mit einem Python-Skript nachbilden.
Pseudo Random Number Generator (PRNG)
Es stellt sich heraus, dass ich Stunden damit verbracht habe, diesen Codeabschnitt zu reversen, der versuchte, die nächste Zufallszahl des Pseudo Random Number Generators oder PRNG zu erzeugen:
.text:98CB7 ; ---------------------------------------------------------------------------
.text:98CB7 push    di
.text:98CB8 mov     ax, ds:8DBh
.text:98CBB mov     cx, word_200
.text:98CBF mul     cx                              ; Unsigned Multiplication of AL or AX
.text:98CC1 xchg    ax, di                          ; Exchange Register/Memory with Register
.text:98CC2 mov     bx, dx
.text:98CC4 mov     ax, ds:8DDh
.text:98CC7 mul     cx                              ; Unsigned Multiplication of AL or AX
.text:98CC9 add     bx, ax                          ; Add
.text:98CCB mov     ax, word_200
.text:98CCE mul     word ptr ds:8DBh                ; Unsigned Multiplication of AL or AX
.text:98CD2 add     bx, ax                          ; Add
.text:98CD4 add     di, word_204                    ; Add
.text:98CD8 adc     bl, byte ptr word_204           ; Add with Carry
.text:98CDC xor     bh, bh                          ; Logical Exclusive OR
.text:98CDE mov     dx, di
.text:98CE0 mov     ds:8DBh, dx
.text:98CE4 mov     ds:8DDh, bx
.text:98CE8 pop     di
.text:98CE9 nop                                     ; No Operation
.text:98CEA fild    dword ptr ds:8DBh               ; Load Integer
.text:98CEE nop                                     ; No Operation
.text:98CEF fdiv    flt_208                         ; Divide Real
.text:98CF3 mov     bx, 0EDh ; 'f'
.text:98CF6 nop                                     ; No Operation
.text:98CF7 fstp    dword ptr [bx]                  ; Store Real and Pop
.text:98CF9 xchg    ax, bx                          ; Exchange Register/Memory with Register
.text:98CFA nop                                     ; No Operation
.text:98CFB wait                                    ; Wait until BUSY# Pin is Inactive (HIGH)
.text:98CFC retn                                    ; Return Near from Procedure
.text:98CFC ; ---------------------------------------------------------------------------
Da dieser Codeabschnitt in .text liegt, nahm ich an, es sei ein von den Arbisers
geschriebener Algorithmus und nicht Teil von BRUN40.EXE. Es hätte gereicht zu bemerken, dass wir in einem anderen Segment waren, wenn man sich den Offset von .text ansah, und fertig, aber neeeein.
Erinnert ihr euch, dass der MSDOS-Quellcode geleakt wurde? Nun, manchmal kann man mit Tunnelblick vergessen, dass man
andere Blickwinkel hat, um dasselbe Problem anzugehen. Im Leak finde ich Folgendes:
; 45 > runtime > rt > random.asm:240
;***
;GetNextRnd -- get next random number
;MakeFloat -- make the number in [b$RndVar] into a R4
;
;Purpose:
;	Get next random number in sequence.
;Entry:
;	[b$RndVar] has the seed.
;Exit:
;	[AX]	= *B$AC which contains the R4 result
;Exceptions:
;	none
;*******************************************************************************

cProc	GetNextRnd,<NEAR>

cBegin
	PUSH	DI
	MOV	AX,[WORD PTR b$RndVar]	 ;low half of previous number
	MOV	CX,[RndA]	;low half of A
	MUL	CX
	XCHG	AX,DI		;save low half in DI
	MOV	BX,DX		;  high half in BX
	MOV	AX,[WORD PTR b$RndVar+2] ;high half of previous
	MUL	CX
	ADD	BX,AX		;sum partial products
	MOV	AX,[RndA]
	MUL	[WORD PTR b$RndVar]
	ADD	BX,AX		;last partial product (since we're mod 2^24)
	ADD	DI,[RndC]	;add in constant C
	ADC	BL,BYTE PTR [RndC]
	XOR	BH,BH		;extended 24-bit number to 32 bits for NORM
	MOV	DX,DI		;number in BX:DX
	MOV	[WORD PTR b$RndVar],DX	 ;save for next time
	MOV	[WORD PTR b$RndVar+2],BX
	POP	DI
MakeFloat:

	FILD	b$RndVar	; put 24-bit integer on numeric stack
	FDIV	FP_2T24 	; ST0 = seed/2^24
	MOV	BX,OFFSET DGROUP:B$AC
	FSTP	DWORD PTR [BX]	; put s.p. equivalent into FAC
	XCHG	AX,BX		; result is *R4 in AX
	FWAIT			; ensure result in RAM prior to return

cEnd				; exit to caller
Das ist derselbe Codeabschnitt! Und es ist genau der PRNG.
Ich habe nicht genau nachgesehen, warum dieser Teil der Runtime in .text lag, denn
ich nahm direkt an, dass es nicht innerhalb desselben Segments
sprang, sondern dass das Modul von TRUCO.EXE in einem Segment
und BRUN40.EXE in einem anderen lag.
Die Feier dauerte nicht lange. Nachdem ich den PRNG lokalisiert hatte,
ließ ich ein kleines Programm in QB4 und seine ausführbare Datei laufen, in beiden ohne RANDOMIZE, um
in allen Läufen denselben Seed-Wert zu haben.
print rnd
print rnd
print rnd
print rnd
print rnd
Die Ergebnisse des QB4-Interpreters und der vom Compiler erzeugten ausführbaren Dateien
waren VERSCHIEDEN. Das Warum würde einen weiteren Artikel erfordern, also habe ich, als ich diesen Unterschied sah,
beschlossen, nur mit den kompilierten ausführbaren Dateien zu arbeiten und keinem Ergebnis des QB-Interpreters zu vertrauen.
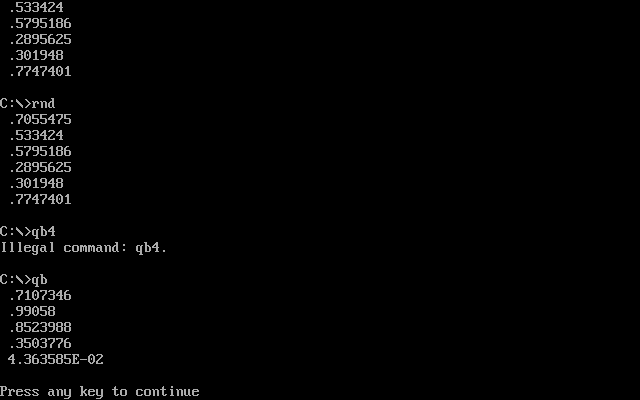
Nach einer langen Pause habe ich in C eine Bibliothek implementiert, um mit CTypes in Python auf
den LCG von QB4 zugreifen zu können. Die Idee, diesen Abschnitt von QB4 getrennt zu haben, war, andere Sprachen für Experimente nutzen zu können
und gut zu verstehen, welche Eigenschaften dieser PRNG haben könnte.
Die Idee war, Python statt Quick Basic zu benutzen, um Ideen und Eigenschaften dieses speziellen LCG herauszuarbeiten.
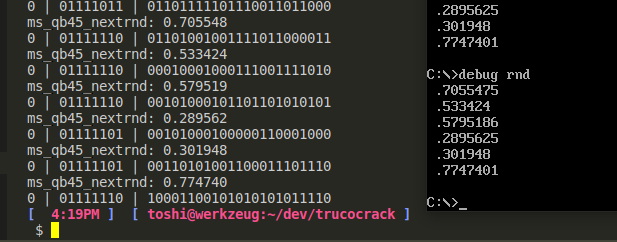 Die Ausgabe unter MSDOS und in meiner Implementierung in C
Eine Randbemerkung: Den PRNG hatte ich von Hand gereversed, und die Bestätigung durch den Screenshot oben kam, bevor ich Zugang zum MSDOS-6.0-Leak hatte. Es stellt sich heraus, dass die Formel, die sie zum Randomisieren von Werten benutzten, als Kommentar im Header der Datei stand. Ich war glücklich, weil ich meine Implementierung auf verschiedene Weisen bestätigen konnte und wusste, dass sie perfekt war.
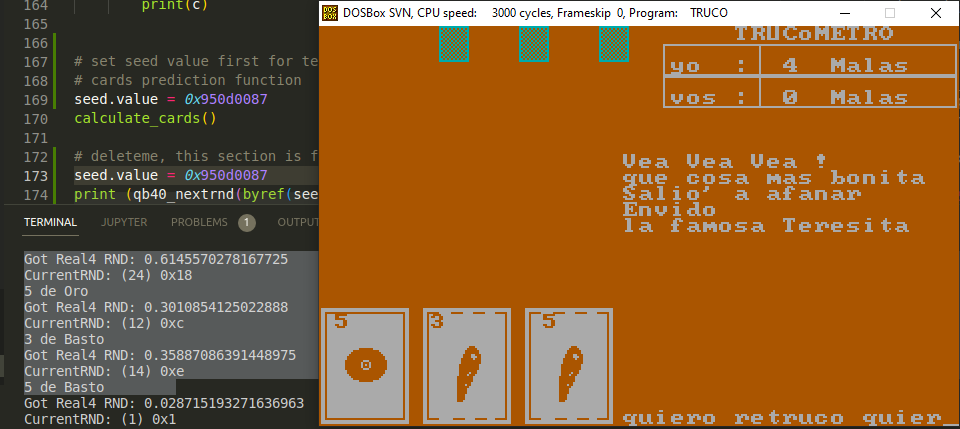
Da ich den PRNG nun mehr oder weniger zum Laufen hatte, versuchte ich, den Seed zu finden.
Mein Vorgehen war eine Zeit lang, nachdem ich identifiziert hatte, wo der Seed des PRNG
geschrieben wurde, bei jeder Hand den Wert des Seeds im Speicher von Hand zu prüfen und ein Python-Skript laufen zu lassen, um
die Hand der CPU zu berechnen.
Das Interessante ist, dass es hervorragend funktionierte und ich mir vor lauter Vorfreude fast in die Hose veröffentlicht hätte, aber nach ein oder zwei Händen verlor ich irgendwie die "Synchronisierung" mit dem Seed: Manchmal entschied das Programm, ein Lied zu spielen, einen Text zu schreiben oder gar nichts zu tun, und das ließ die Aufrufe des LCG fortschreiten. Ich verbrachte unglaublich viel Zeit damit, in jedem Fall zu debuggen oder zu versuchen zu debuggen, wie oft zum nächsten PRNG-Wert weitergeschaltet wurde, und wer schon einmal versucht hat, auf Intel 16 Bit zu debuggen, weiß, wie schwierig es manchmal ist, dem Code bei so vielen Segmentwechseln zu folgen. Puh.
Ich konnte ihr also schon teilweise die Karten lesen, aber manchmal "desynchronisierte" ich mich, und jedes Mal, wenn ich es debuggend nachverfolgte,
steckte ich unglaublich viele Stunden hinein, ohne zu einem ausreichend starken Schluss zu kommen, ich konnte nicht herausfinden, wie stark die Anzahl
der Aufrufe der Funktion get_random variierte, und ich ließ es für eine Weile liegen, bis…
Aber wozu zum Teufel hast du dann einen PC?
Als ich das Problem des Truco Arbiser mit ein paar Freunden diskutierte und ihnen von meiner Frustration mit dem Debugging erzählte, zeigte ich ihnen diesen Codeabschnitt des LCG:
/*
# According to Microsoft, this is the linear congruential method for prng
# x1 = (x0 * a + c ) mod 2 ^ 24
#
# where
#
# x1 = new random number from [0 to 2^24]
# x0 = previous number (or seed, for the first one)
# a = 214013
# c = 2531011
# the random number returns a float
# x1 / 2^24

*/
float ms_rnd_formula(uint32_t *prev_rnd) {

    // a and c constant values are found at 021e:e020 as
    // FD 43 03 00 => A
    // C3 9E 26 00 => C
    uint32_t a = 214013; // 0x343fd
    uint32_t c = 2531011; // 0x269ec3
    float x1;
    uint32_t p;

    p = pow(2,24);
    x1 = ((*prev_rnd * a) + c) % p;

    *prev_rnd = x1;
    return x1 / p;
}
Worauf mich jemand fragt:
– Warum berechnest du nicht vor, alle Zufallszahlen auf einmal, statt dich mit dem Seed irgendwo zu positionieren und mehrere Schritte vorauszuschauen, ob die Karten deiner eigenen Hand in der nächsten Hand sind oder nicht?
– Weil das 2^24 Elemente sind, die ich berechnen müsste, also ~16 Millionen Möglichkeiten, und das ist eine Menge Rechnerei und Speicher… für eine Maschine aus den 80'ern!
Mulero
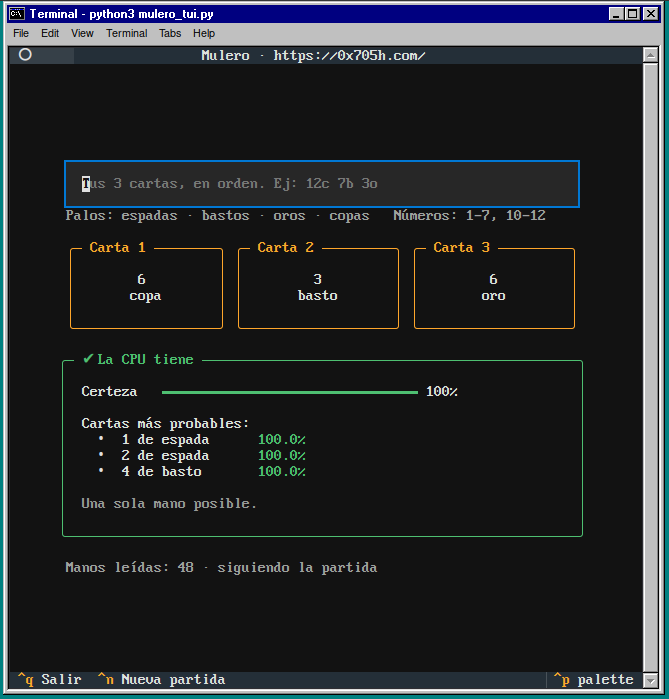 Die Textoberfläche von Mulero
Immer wieder im LCG-Zyklus herumdrehen
Der LCG von QB4 hat, wie wir immer wieder sagen, die Form:
estado = (estado * A + C) mod 2^24
RND    = estado / 2^24
Die effektiven Konstanten sind A = 0xfd43fd und C = 0xc39ec3. Die Kommentare von Microsoft sagen etwas anderes, weil die Runtime die untere Hälfte jeder Konstante lädt, wo sie die obere laden sollte. Die Details stehen in der README des Repositorys.
Beim Durchsehen von Mustern von Zufallszahlengeneratoren und ihren Problemen stieß ich unter anderem auf den Satz von Hull-Dobell, der besagt,
dass ein LCG mit Modulus m alle seine m Zustände durchläuft, bevor er sich wiederholt, genau dann wenn:
-
Cundmteilerfremd sind. -
A - 1durch alle Primzahlen teilbar ist, diemteilen. -
A - 1durch 4 teilbar ist, wennmes ist.
Hier ist m = 2^24, also ist die einzige Primzahl die 2 und die Bedingungen reduzieren sich auf C ungerade und A ≡ 1 (mod 4).
Die Konstanten erfüllen beide: 0xc3 ist ungerade und 0xfd = 253 = 4*63 + 1.
Das bedeutet, dass die 16.777.216 Zustände einen einzigen Kreis bilden. Jeder Zustand nimmt eine Position ein, und den Generator laufen zu lassen heißt, auf diesem Kreis zu wandern. Die "nächste Hand" ist die aktuelle Position plus eine gewisse Anzahl von Schritten, nämlich die, die das Austeilen verbraucht hat, plus die, die Gedichte, Beschimpfungen und Lieder verbraucht haben.
Zur Zeit des Debuggens war es, glaube ich, dieses "Fenster" von Aktionen (die Auswahl von Gedichten, Beeper-Liedern und Beschimpfungen), das mir die Position, an der ich mich befand, desynchronisierte, und alle Fälle zu debuggen, abhängig von einer Zufallszahl, die eine beliebige Anzahl von Aufrufen der Funktionen auslöst, die weitere Zufallszahlen holen, wurde sehr mühsam. Diese andere Lösung, die ich vorschlage, erspart mir direkt, die "Anzahl" der Aufrufe von RND zu berechnen.
Nur drei Hände, Jung3!
Der Zustand hat 24 Bit Unsicherheit. Drei verschiedene Karten aus 40 zu sehen liefert dir log2(40*39*38) ≈ 15,9 Bit an Information, das heißt, es nimmt dem Zustand 15,9 Bit Entropie (Unsicherheit)4.
Eine einzelne Hand reicht nicht: Es gibt 2^24 / (40*39*38) ≈ 283 kompatible Positionen.
Mit einer Hand gewinnst du ~15,9 Bit. Die folgenden Hände tragen deutlich weniger bei, weil uns das Fenster WINDOW schon ungefähr sagt, wo sie landen, und deshalb
reichen uns 3 Hände.
Um die Hände zu verbinden, benutzen wir ein Fenster.
Die neue Hand muss höchstens WINDOW = 1000 Schritte von dem Punkt entfernt beginnen, an dem die vorherige endete.
Ein falscher Kandidat hat eine Wahrscheinlichkeit von 283 * 1000 / 2^24 ≈ 1,7 %, das zufällig zu erfüllen. Bei der dritten Hand überlebt fast kein falscher Kandidat mehr.
Die Wahrscheinlichkeit ist gering, aber nicht null. Ab und zu kann es beim Benutzen von Mulero passieren, dass du gerade spielst und plötzlich mehrere Hände in diesem Fenster liegen,
die die Bedingungen erfüllen; in diesem Fall merkt Mulero das und sagt dir, dass es in diesem Moment der Partie keine 100%ige Gewissheit gibt, und
es genügt, ein oder zwei weitere Hände zu spielen, um sich "neu zu zertifizieren" (?).
numpy
Dafür brauchen wir eine Tabelle mit 16 Millionen Einträgen und einer Menge Vergleiche.
In reinem Python kostet jeder Durchlauf eines for etwas Interpreter-Zeit (Typen prüfen, int-Objekte von ~28 Bytes erzeugen), was alles etwas langsam macht.
In NumPy liegen die Daten in einem zusammenhängenden Speicherblock mit festem Typ (uint8 belegt 1 Byte) und die for-Schleifen laufen in C statt in Python.
a * x + c auf ein Array zu schreiben bedeutet, das for auszuführen, ohne es zu schreiben. Das nennt man Vektorisieren.
valor = ciclos[a * x + c] # alles ist bereits vorberechnet
Den Kreis vorberechnen
Das Problem ist, dass jeder Zustand vom vorherigen abhängt, also scheint er nicht vektorisierbar zu sein.
Der Ausweg ist der Sprung nach vorn (jump-ahead).
Ein Schritt des LCG ist eine lineare Funktion f(x) = A*x + C.
Die Verkettung zweier linearer Funktionen ergibt wieder eine lineare Funktion:
A*(a*x + c) + C = (A*a)*x + (A*c + C)
So können wir berechnen, was 4096 Schritte auf einmal vorrückt:
ak, ck = 1, 0
for _ in range(4096):
    ak = (ak * A) & MASK
    ck = (ck * A + C) & MASK
# jetzt: estado[n + 4096] = ak * estado[n] + ck
Den ersten Block von 4096 Zuständen berechnen wir von Hand. Jeder folgende Block entsteht aus dem vorherigen mit einer einzigen Operation auf einem Array:
state[b*4096:(b+1)*4096] = (state[(b-1)*4096:b*4096] * ak + ck) & MASK
Das sind 4096 Python-Durchläufe plus 4096 vektorisierte Operationen, statt 16 Millionen Durchläufen.
In diesen Zeilen stecken mehrere NumPy-Details:
-
& MASKstatt% N: DaNeine Zweierpotenz ist, istx mod 2^24gleichx & (2^24 - 1). Das ist schneller und funktioniert nur mit Zweierpotenzen. -
dtype=np.uint64:estado * Aerreicht ~2^48 und würde eine 32-Bit-Ganzzahl überlaufen lassen. -
state[a:b]ist eine View, keine Kopie. Etwas zuzuweisen schreibt in das ursprüngliche Array. -
np.emptyreserviert Speicher ohne ihn zu initialisieren, weil wir ihn komplett füllen werden.
Vom Zustand zur Karte
Truco ist ein Spiel mit 40 Karten im Stapel. Die Reihenfolge, in der ich das Array geschrieben und zusammengesetzt habe, um herauszufinden, wie TRUCO.EXE es macht, ergibt sich daraus, wie
die Kartenauswahl im Programm berechnet wird und in welcher Reihenfolge sie im Speicher erscheint.
https://codeberg.org/toshi/mulero/src/branch/master/mulero.py#L35:
# card stuff
# cards goes from 0..39 with suit*10 + index, where suit is 0..3 and index is 0..9
SUITS = "eboc" # suits are: e=espada, b=basto, o=oro, c=copa
SUITS_NAMES = ["espada", "basto", "oro", "copa"]
NUMBERS = [1, 2, 3, 4, 5, 6, 7, 10, 11, 12]
Wenn ihr euch die Funktion lcg_table() anseht: INT(RND * 40) ist floor(40 * estado / 2^24).
Durch 2^24 zu teilen und abzuschneiden bedeutet, 24 Bit nach rechts zu schieben, sodass (state * 40) >> 24 übrig bleibt, ein Wert von 0 bis 39.
Da RND zuerst den Zustand weiterschaltet und dann zurückgibt, stammt die Karte an Position p aus dem Zustand p+1.
Das löst np.roll(cartas, -1), das das Array zyklisch verschiebt (das Ende ist mit dem Anfang verbunden, genau das, was ein Kreis braucht).
Das Ergebnis ist CARDS, ein 16-MB-Array, bei dem CARDS[p] die Karte ist, die an Position p ausgeteilt würde.
Die Hand suchen
start = np.flatnonzero(CARDS == mi_primera_carta)
CARDS == x erzeugt ein Array mit 16 Millionen Booleans und flatnonzero gibt die Indizes zurück, an denen True steht.
Mit einer einzigen Zeile bleibt 1/40 der Positionen übrig, etwa 419 Tausend.
Danach simuliert deal() das Austeilen für alle diese Kandidaten parallel.
Da das Spiel erneut zieht, wenn eine bereits vorhandene Karte herauskommt, braucht jeder Kandidat eine andere Anzahl von Ziehungen.
Das wird mit einer Liste pend derjenigen gelöst, die noch eine Karte brauchen:
c = CARDS[pos[pend] & MASK]                          # fancy indexing: viele Elemente auf einmal herausholen
repeated = (hand[pend, :k] == c[:, None]).any(axis=1)
- Fancy indexing: ein Array mit einem anderen Array von Indizes indizieren.
-
Broadcasting:
hand[pend, :k]hat die Form(n, k)undc[:, None]die Form(n, 1). NumPy "streckt" die Spalte und vergleicht jede neue Karte mit denkbereits ausgeteilten. -
.any(axis=1)faltet die Spalten zusammen und beantwortet für jede Zeile "Hat sich irgendeine wiederholt?". -
~repeatedist die bitweise Negation. Bei Arrays kann man nichtnotbenutzen.
Nach jeder der ersten drei Karten werden die Kandidaten verworfen, die nicht zu deiner Hand passen (start = start[ok], eine boolesche Maske).
Von 419 Tausend kommt man auf etwa ~283, und die Karten der CPU werden nur für diese simuliert.
Hände verketten
gap = (start[:, None] - prev_end[None, :]) & MASK
ok  = (gap <= WINDOW).any(axis=1)
Wenn man einen Spaltenvektor (n, 1) und einen Zeilenvektor (1, m) subtrahiert, erhält man eine (n, m)-Matrix mit allen paarweisen Differenzen, ganz ohne for.
Das & MASK auf negativen Zahlen liefert den korrekten Modulo (die zirkuläre Distanz).
Das .any(axis=1) fragt, ob dieser Kandidat weniger als WINDOW Schritte von irgendeinem Ende der vorherigen Hand entfernt liegt.
Schließlich sortiert np.sort(cpu, axis=1) die Karten jeder Kandidatenhand, sodass {3, 7, 9} und {9, 3, 7} als dieselbe zählen,
und np.unique(axis=0, return_counts=True) gruppiert die gleichen Zeilen und
zählt, wie oft jede vorkommt. Wenn nur noch eine mögliche Hand übrig bleibt, weißt du schon, was die CPU hat.
Jetzt lade dir Mulero herunter und schlag es endlich!
Quellcode
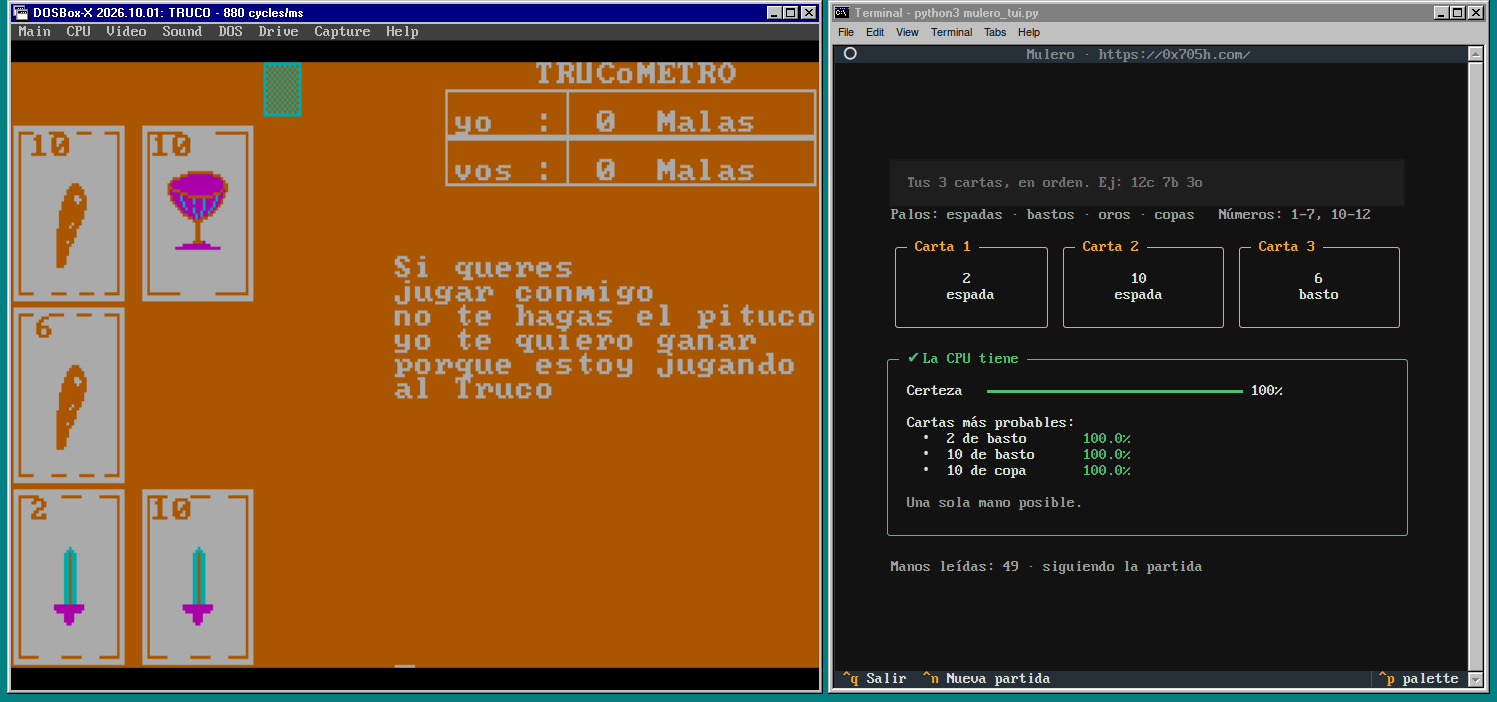 Mulero in Aktion
Den Quellcode von Mulero kannst du aus dem Codeberg-Repository herunterladen: https://codeberg.org/toshi/mulero
Referenzen
- Truco Arbiser
- PC Tech Journal Volume 06 Number 06 JUNE 1988
- BASIC Techniques and Utilities
- MZ File Structure
- x86 Instruction Chart
- Intel® 64 and IA-32 Architectures Software Developer’s Manual Volume 2 (2A, 2B, 2C & 2D): Instruction Set Reference, A-Z
- x86 Instruction Set Reference
- X86 Opcode and Instruction Reference Home
- IEEE-754 Online Floating Point Converter
- Capstone Engine
- PRNG
- LCG
- README
- Mulero
- NumPy
- Satz von Hull-Dobell
- jump-ahead
Fußnoten
-
Damals schrieb ich "wurde 1986 kompiliert", weil der Copyright-Vermerk im Spiel ebenfalls 1986 nennt, aber Quick Basic 4.0 wurde 1987 veröffentlicht! ↩ ↩2
-
Das habe ich allerdings etwa vier Jahre vor der Veröffentlichung dieses Artikels geschrieben, und hätte ich die
Reversing-Arbeit noch ein wenig weitergeführt, hätte ich mir die ganze Arbeit sparen können, einen Disassembler für QB4 zu bauen. Ich war viel näher dran, als ich damals dachte. ↩ ↩2 -
Es war nicht trivial für mich zu erkennen, dass es dieses Format war, der IEEE754-Gleitkommastandard, den ich unter die Lupe nahm. In einem viel früheren Beitrag auf einem Blog, den es nicht mehr gibt, hatte ich ein anderes Format gereversed, nämlich MBF (Microsoft Binary Format), und da ich annahm, dass Microsoft dasselbe Format verwenden würde wie in anderen Programmen, kam ich nicht so leicht auf die Idee, dass sie vielleicht den IEEE-Standard benutzen. ↩
-
Entropie ist der Logarithmus zur Basis 2 der Anzahl gleich wahrscheinlicher Möglichkeiten (jedes Bit halbiert die Kandidaten). Wie man auch in xkcd Nr. 936 sehen kann, addieren sich die Bits an Entropie nur, wenn die Entscheidungen unabhängig voneinander sind. ↩